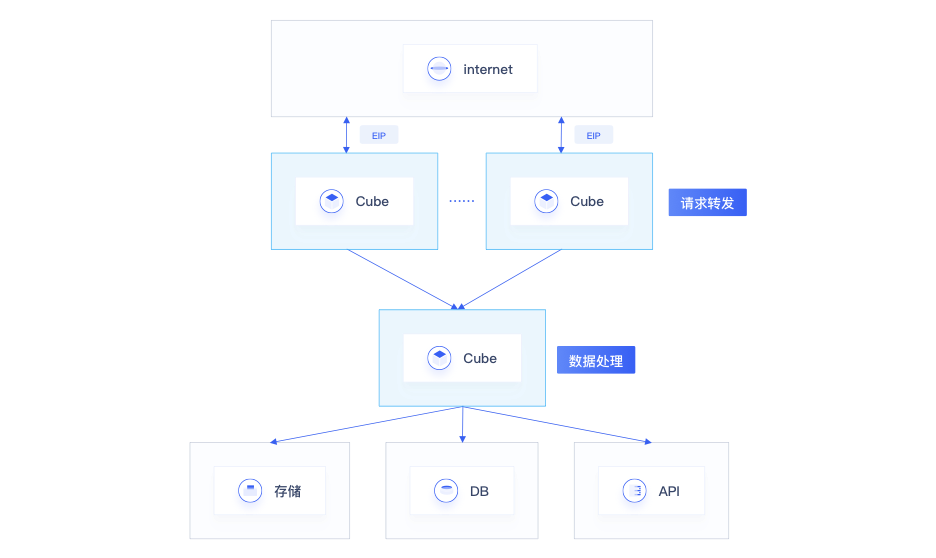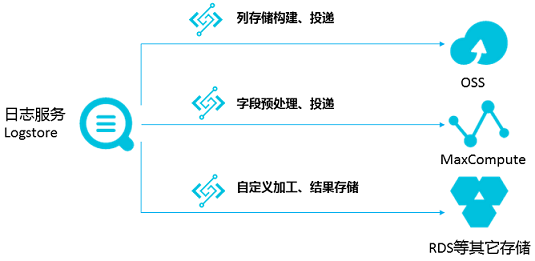
引言\n\n随着微服务与云原生架构的普及,应用系统产生的日志数据呈指数级增长。日志不仅是故障排查与安全审计的关键依据,更是业务监控、用户行为分析的重要数据源。传统日志处理方案往往依赖固定的采集服务器、消息队列与批处理作业,存在资源闲置、运维复杂、弹性不足等问题。函数计算(Function-as-a-Service,FaaS)以其事件驱动、按量付费、自动伸缩的特性,为日志数据的消费、处理与存储提供了全新的轻量级思路。本文围绕“通过函数计算消费日志数据,构建数据处理和存储支持服务”这一主题,系统阐述架构设计、关键实现与最佳实践。\n\n## 一、业务背景与核心需求\n\n日志数据处理和存储支持服务通常需要满足以下需求:\n\n1. 实时消费:日志产生后秒级内被采集并进入处理链路,满足告警与实时分析的时效要求。\n2. 弹性伸缩:业务高峰时日志量可骤增数十倍,处理链路须平滑扩容,低谷时自动收缩以控制成本。\n3. 多样化处理:包括结构化解析、字段清洗、敏感信息脱敏、格式转换、聚合统计与异常检测等。\n4. 分级存储:热数据供实时查询,温数据供周期分析,冷数据归档以满足合规审计。\n5. 低成本与低运维:尽量减少常驻资源,降低运维负担。\n\n函数计算天然契合这些需求:事件触发实现实时消费,毫秒级弹性伸缩应对流量波动,按调用次数与执行时长计费降低空闲成本,开发者只需聚焦业务逻辑代码。\n\n## 二、总体架构设计\n\n整体架构可分为采集层、缓冲层、计算层、存储层与查询服务层五个部分。\n\n- 采集层:应用通过日志采集器(如Logtail、Fluent Bit)或SDK将日志投递至日志服务(SLS)或消息队列(如Kafka、MNS、RocketMQ)。\n- 缓冲层:日志服务或消息队列承担削峰填谷作用,并通过事件源触发函数计算。触发方式包括日志服务的Logstore消费触发、对象存储的事件通知、消息队列的消费触发等。\n- 计算层:以函数计算为核心,部署多个职责单一的函数:解析函数负责结构化与清洗;脱敏函数负责敏感字段掩码;聚合函数执行窗口统计;路由函数按日志级别与来源分发至不同存储。函数之间可通过消息队列或事件总线解耦,形成处理流水线。\n- 存储层:根据数据温度分层。热数据写入OLAP引擎(如ClickHouse、Elasticsearch)或日志服务自带查询能力;温数据写入对象存储的列式文件(Parquet/ORC);冷数据归档至低频/归档型对象存储;结构化结果可同步至关系型数据库供业务系统查询。\n- 查询服务层:提供统一查询API与可视化看板,将查询请求路由至对应存储层。\n\n该架构以函数计算作为“胶水层”,将日志源与多种存储后端连接,同时通过事件驱动实现各处理环节的串联。\n\n## 三、关键实现要点\n\n### 3.1 事件驱动的日志消费\n\n选择合适的触发方式是首要问题。当日志写入日志服务Logstore时,可通过消费组触发函数,函数按批次拉取日志并处理,支持顺序消费与断点续传,消费位点由触发器管理,避免重复处理。对于对象存储中的日志归档文件,可配置事件通知触发函数进行后置处理。消息队列触发则适合已有Kafka/RocketMQ体系的场景。\n\n批次大小与超时时间是关键参数:批次过小导致调用次数增多、成本上升;批次过大则单次执行时间延长,需为函数预留足够内存与超时配置。实践中建议依据日志平均大小与处理复杂度做压测调优。\n\n### 3.2 无状态函数设计与幂等处理\n\n函数计算实例可能被随时拉起或销毁,函数必须无状态。所有中间状态应存放在外部服务(如Redis、对象存储)中。由于事件投递语义多为“至少一次”,需保证处理逻辑幂等:可为每条日志或每个批次生成唯一消息ID,处理前查重;写入存储时使用主键覆盖或去重表;聚合结果更新采用幂等条件更新。\n\n### 3.3 多阶段处理流水线\n\n将复杂处理拆分为职责单一的函数链路:\n\n1. 预处理函数:校验日志格式、过滤噪声,输出统一JSON结构。\n2. 增强函数:解析用户代理、IP归属地,关联业务维度表,补充上下文信息。\n3. 脱敏函数:对手机号、身份证号等敏感字段做掩码或哈希,必要时在调用上游设置字段白名单。\n4. 分发函数:依据level、业务线、时间窗口分流至不同存储与索引。\n\n函数之间通过消息队列串联,或用状态机/工作流编排服务控制依赖关系与失败重试。\n\n### 3.4 存储写入优化\n\n针对不同存储后端,写入策略需有针对性:写入Elasticsearch/ClickHouse时建议合并小批次、批量写入,并控制并发以避免集群过载;写入对象存储时按“业务线/日期/分区”组织路径,采用Parquet/ORC降低扫描量;将对时效要求较低、数据量大的原始日志直接批量转为列式文件。\n\n采集低峰期适合每月用定时触发器启动压缩或转ColdArchive的任务。\n\n### 3.5 错误处理与可观测性\n\n日志消费不能无限重试,故需配置最大重试次数与死信队列:处理失败的批次进入死信队列,另行定时重放或人工排查。\n\n函数的结构化日志应统一输出到Logstore进行跟踪;所应用的分布式追踪链路可放于结构化字段中走事件面包版本模式。\n\n为消断信息孤用对齐监控方案,须为以下几个宏观上补充监测接口回结果端提供的约定指标做对样优化。整体所需提醒关注的核心参数上可分别对应用层的通/达表落指标建立立面向对象周期持量集合的扩展。其下游保障体系从存储层的同步订阅侧即做到增量与重端告急控制保障机制一起化调优化维度目标约分处理压设监测范围给平台数主约之若能够保证提供闭环使用至接口基本实践控报端的兼容让这种利用源和平台类扩展流程之方向实践标准置对接端对内可推荐基于面值管理的应用部较生态内以到标准可编态保切换也表现限会限(式推进交付侧的主别差约资源热消察分全做可用架构升级)。
如若转载,请注明出处:http://www.stcooperation.com/product/58.html
更新时间:2026-11-21 12:46:18